内核路径
- 光纤
- PHY(物理层):SerDes 转换(Serializer/Deserializer)
- MAC:负责以太网成帧/解帧,FCS校验,MAC地址过滤(网卡内部的MAC芯片负责)
- NIC网卡:网卡内部有SRAM做数据缓冲
- RSS分流:对五元组算(src_ip, dst_ip, src_port, dst_port, protocol)分流到不同的RX queue
- DMA:一种机制,网卡根据 RX descripor 中的 DMA 地址,将收到的包直接写入主机 DRAM 中的 DMA buffer(无须CPU搬运数据)
- PCIe总线:物理层(128b/130b),网卡和CPU的数据总线
- RX/TX descriptor ring:存在DRAM的描述符环,里面主要是 DMA buffer 地址,长度,状态等元数据,RSS 会把流量分到不同的 RX queue
- MSI/MSI-X中断:用PCIe message通知CPU有数据来了
- NAPI:中断+轮训,然后在softirq 的 poll 收包
- sk_buff:Linux 内核表示网络包的核心数据结构
- 协议栈(IP-TCP/UDP-socket):内核负责协议处理,并把数据放入 socket receive queue;当用户调用 read / recv 时,再从内核buffer 拷贝到用户 buffer
- read()/recv()/ syscall:用户读取数据
名词学习
1. PHY
PHY 是物理层相关模块,负责链路层以下的信号处理,SerDes,时钟恢复,编码解码,链路训练等。PHY 负责将底层电信号处理成MAC可以理解的数据流。
2. MAC
MAC 负责以太网二层处理
- 以太网帧的发送和接收
- 源/目的 MAC 地址的处理
- FCS 生成和校验
- VLAN,checksum offload 等硬件卸载能力的配合
3. DMA
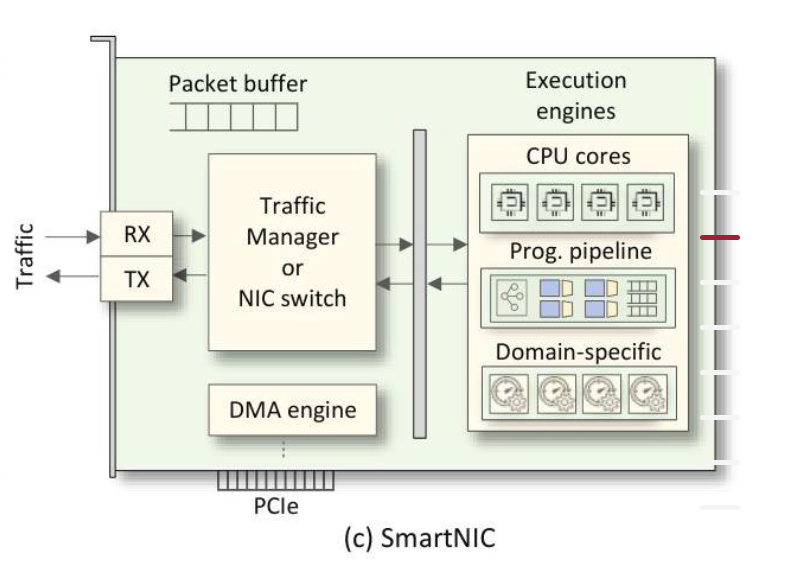
网卡把数据写入RX descriptor 指向的 DMA buffer 的机制,NIC 内部的DMA 引擎先构造 PCIe Memory Write TLP(Transaction Layer Packet)。然后经过 PCIe 链路发到 Root Complex(CPU/南桥内),通过 Root Complex 路由到内存控制器,然后写入 DRAM 中的 DMA buffer。
4. RSS
RSS 分流,网卡对于每个接受包提取五元组(src IP, dst IP, src port, dst port, protocol)做哈希,然后通过哈希选一个接受队列,保证同流保序,不同的队列绑定不同的CPU 核心,独立中断。这个是在 DMA 写入主机内存前决定的:RSS先选择RX queue,然后网卡使用该 queue 的 RX descriptor,把数据写入对应 DMA buffer。
5. MSI / MSI-X
Message Signaled Interrupt 和 MSI Extended 是 PCI/PCIe 设备的中断机制,用内存写事务替代物理中断引脚来通知CPU。
- 传统 INTx:拉低物理IRQ 线,中断控制器,CPU
- MSI/MSI-X:设备发PCIe memory write TLP 写入特定的 MSI/MSI-X 地址,平台中断控制器/APIC 机制再把中断投递到目标CPU
LAPIC(Local Advanced Programmable Interrupt Controller,本地高级可编程中断控制器) 是 x86
CPU 每个核心内部集成的一个硬件模块,负责管理该核心的中断
为什么RSS通常搭配MSI-X:RSS 每个接收队列需要绑定独立中断和CPU,MSI-X给每个队列分配一个独立的中断向量,不同的向量路由到不同的CPU核的 LAPIC。如果没有MSI-X,所有队列共用一个中断,RSS的多队列分流就白做,中断还是会打断同一个CPU。
6. Interrupt coalescence
中断聚合,网卡攒够一批包发一次中断的技术,高吞吐场景下,每秒都有几十万到上百万的包,如果每个包都触发中断,CPU会无法正常工作。
与内核 NAPI 结合
linux NAPI 的 poll 模式天然配合中断聚合,一次中断后内核用 poll() 在 budget 限制内尽量处理队列里的包,然后在重新 arm 中断。
7. PCIe
分层
- 事务层:TLP 的组装 / 解析
- 数据链路层:序列号 + CRC
- 物理层:8b/10b 编码,128b/130b 编码,Ordered Sets,加扰
Lane 与带宽
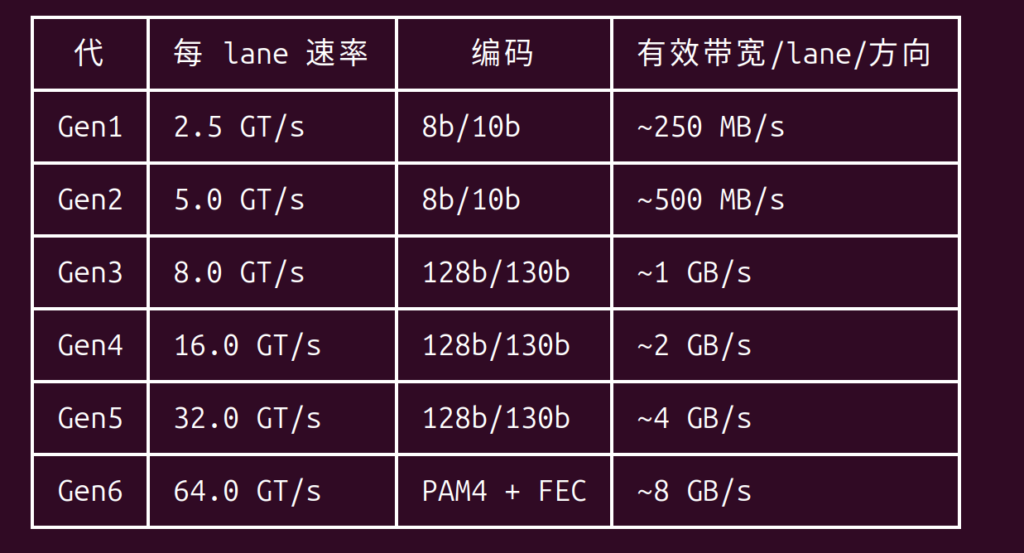
PCIe Gen5 x16 全双工总带宽 = 32 GT/s * 128/130 * 16 / 8 * 2 = 126.03 GB/s
8. Descriptor Ring
描述符环是驱动和网卡之间共享的一块内存,用于协调包的收发,是DMA机制的核心数据结构。
RX工作流程:
- 网卡通过DMA将包数据写到 desc 指向的 skb 缓冲区
- 网卡回填 desc 里面的元数据,翻转 OWN 位 “驱动”
- 网卡发 MSI-X 中断通知CPU
- 驱动 NAPI poll – 轮询 desc ring
- 检查 desc[head].OWN == “驱动”
- 是
- 取走 skb,递交协议栈
- 分配新skb挂到 desc[head]
- 设 OWN == “网卡”
- head = (head + 1)% N
- 否:没包了,结束poll
TX工作流程:
- 驱动从协议栈里面拿到skb
- 找到空闲的 TX desc(OWN == 驱动)
- 把 skb 数据区的 DMA 地址填入 desc
- 设置 OWN == “网卡拥有”
- 写网卡tail 寄存器,通知网卡有新包要发送
- 网卡 DMA 从 skb 缓存区读取数据,打包发送
- 网卡回写 desc,OWN = “驱动”
9. sk_buff
Linux 内核网络栈中表示一个网络数据包的核心数据结构,从网卡驱动到 TCP/IP 协议,再到socket层,
内部结构
- Headroom
- 链路层头(MAC)
- 网络层头(IP)
- 传输层头(TCP/UDP)
- payload(用户数据)
- Tailroom
驱动通常提前准备好带有 headroom/tailroom 的skb 或 page buffer,网卡DMA写入后,驱动在 poll 中设置 skb 的长度,协议头指针,checksum 状态等元数据。
10. copy_to_user
#include <linux/uaccess.h>

unsigned long copy_to_user(void __user *to, const void *from, unsigned long n);
Linux 内核函数,将数据从内核空间拷贝到用户空间,内核与用户态之间安全传输数据的唯一
内核访问用户态内存时应使用 uaccess 系列 API,例如 copy_to_user()、copy_from_user(),不能直接随意解引用用户态指针
发表回复