作者: cyzh

  • pybind11 库

    一个cpp 的 header only 库,用于将cpp的类型函数暴露给python使用。2017年发布,算一个比较新的库,目前有一些大型的库在使用pybind11,比如 numpy,pytorch,tensorflow,open3d等。

    比如我定义一个类型:

    struct Pet {
        Pet(const std::string &name) : name(name) { }
        void setName(const std::string &name_) { name = name_; }
        const std::string &getName() const { return name; }
    
        std::string name;
    };

    然后使用pybind11定义好暴露的类型和函数:

    #include <pybind11/pybind11.h>
    
    namespace py = pybind11;
    
    PYBIND11_MODULE(example, m) {
        py::class_<Pet>(m, "Pet")
            .def(py::init<const std::string &>())
            .def("setName", &Pet::setName)
            .def("getName", &Pet::getName);
    }

    然后就可以通过python来直接调用:

    % python
    >>> import example
    >>> p = example.Pet("Molly")
    >>> print(p)
    <example.Pet object at 0x10cd98060>
    >>> p.getName()
    'Molly'
    >>> p.setName("Charly")
    >>> p.getName()
    'Charly'

    教程:

    https://daobook.github.io/pybind11/classes.html

  • Boost::hana

    背景

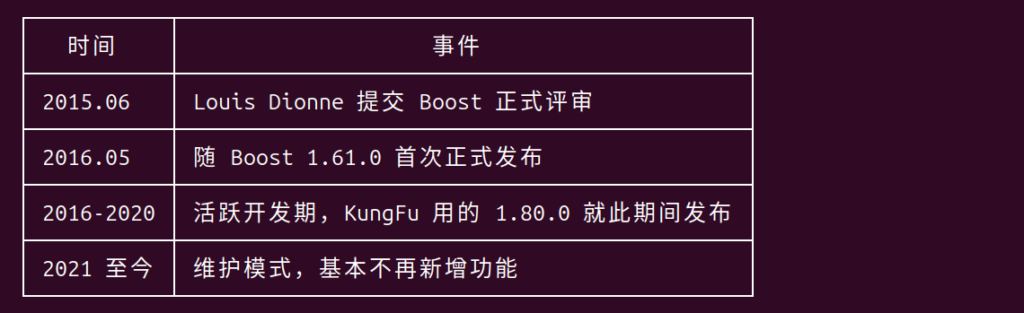
    时间线

    cpp的计算分为4个象限,运行时计算,编译时计算,异构计算和类型计算。Hana的目的是合并第三象限和第四象限的计算。Hana是一个功能齐全的异构算法和容器库,,提供了一种将任何类型计算转化为其等效的异构计算的方法,这就允许异构计算的机制全部重用于类型计算。

    一些入门用法

    类型标签

    // 类型和值的转化
    auto quote_type = hana::type_c<Quote>;     // 类型 → 值
    using QuoteType = typename decltype(+hana::type_c<Quote>)::type;  // 值 → 类型
    
    // 比较
    hana::type_c<Quote> == hana::type_c<Trade>;  // false(编译期结果)
    

    编译期容器

    // tuple 
    auto types = hana::make_tuple(hana::type_c<Quote>, hana::type_c<Trade>);
    
    // map
    auto map = hana::make_map(
        hana::make_pair(hana::type_c<Quote>, 100),    // key 是类型,value 是运行时值
        hana::make_pair(hana::type_c<Trade>, 200)
    );
    
    // pair
    hana::make_pair("key", 42);
    
    // set
    hana::make_set(hana::type_c<Quote>, hana::type_c<Trade>);
    
    // range
    hana::make_range(hana::int_c<0>, hana::int_c<10>);

    编译期常量

    hana::int_c<42>;       // 整数常量
    hana::bool_c<true>;    // 布尔常量
    hana::size_c<10>;      // size_t 常量
    "hello"_s;             // 字符串常量

    使用方法

    容器访问

    // tuple 按 index 访问
    auto t = hana::make_tuple(10, 20, 30);
    
    hana::at(t, hana::int_c<0>);   // 10
    
    // map 按 key 访问
    auto m = hana::make_map(
        hana::make_pair(hana::type_c<Quote>, 100),
        hana::make_pair(hana::type_c<Trade>, 200)
    );
    hana::at_key(m, hana::type_c<Quote>);  // 100
    // 等价于 m[hana::type_c<Quote>]

    遍历

    hana::for_each(hana::make_tuple(1, 2.0, "hi"), [](auto x) {
        std::cout << x << std::endl;
    });

    变换

    auto result = hana::transform(hana::make_tuple(1, 2, 3), [](auto x) {
        return x * 2;  // → tuple(2, 4, 6)
    });

    查找

    auto opt = hana::find_if(tuple, [](auto x) {
        return x > 2;
    });  // 返回 hana::just(...) 或 hana::nothing

    展开

    hana::unpack(hana::make_tuple(1, 2, 3), [](auto... args) {
        return (args + ...);  // 1+2+3 → 6,参数个数在编译期确定
    });

    过滤

    auto result = hana::filter(hana::make_tuple(1, 2.0, 3, 4.0), [](auto x) {
        return hana::traits::is_integral(hana::type_c<decltype(x)>);
    });

    归约

    auto sum = hana::fold(hana::make_tuple(1, 2, 3), 0, [](auto acc, auto x) {
        return acc + x;
    });

    zip

    auto t1 = hana::make_tuple(1, 2, 3);
    auto t2 = hana::make_tuple("a", "b", "c");
    
    hana::zip(t1, t2); 
    // → tuple(pair(1,"a"), pair(2,"b"), pair(3,"c"))

    concat

    hana::concat(hana::make_tuple(1, 2), hana::make_tuple(3, 4));
    // → tuple(1, 2, 3, 4)

    编译期控制流

    if — 编译期分支

    hana::if_(condition, then_value, else_value);
    
    auto result = hana::if_(hana::true_c, 1, 2);   // 1
    auto result = hana::if_(hana::false_c, 1, 2);  // 2

    while — 编译期循环

    hana::while_(predicate, state, body);
    
    auto result = hana::while_(predicate, initial_state, [](auto state) {
        return next_state;
    });

    Maybe 类型

    // Maybe 类型
    auto has_ts = hana::just("update_time"_s);  // 有值
    auto no_ts  = hana::nothing;                 // 无值
    
    hana::is_just(has_ts);   // true_c
    hana::is_just(no_ts);    // false_c
    hana::is_nothing(no_ts); // true_c

    结构体反射

    // 定义类型
    struct Quote {
        double bid_price;
        double ask_price;
    };
    BOOST_HANA_ADAPT_STRUCT(Quote, bid_price, ask_price);
    
    // 获取字段
    hana::for_each(hana::accessors<Quote>(), [](auto field) {
        auto name = hana::first(field);    // "bid_price"
        auto getter = hana::second(field); // 成员指针
    });

    还有一种写法:

    // 定义类型
    BOOST_HANA_DEFINE_STRUCT(Quote,
        (double, bid_price),
        (double, ask_price)
    );
    
    // 获取字段
    hana::for_each(hana::accessors<Quote>(), [](auto field) {
        auto name = hana::first(field);    // "bid_price"
        auto getter = hana::second(field); // 成员指针
    });

    参考

    https://github.com/freezestudio/hana.zh/blob/master/hana-zh.md
  • RSS / RFS / XPS

    1. RSS

    Receive Side Scaling, 解决的问题是:接收到的包应该发到哪个 RX queue,Toeplitz hash 通过五元组(src_ip, dest_ip, src_port, dest_port, protocol)计算一个32bit的值,然后取低几位,通过RSS间接表映射到 queue。

    RSS 不会跨核共享

    每个RX queue绑定独立的 MSI-X 中断, 然后独立绑定核心,包从DMA进来到 NAPI Poll 到 协议栈处理,始终都在一个核心上,没有跨核心数据。

    2. RFS

    Receive Flow Steering,RFS 解决的是:接收到的 flow 应该由哪个 CPU 处理。RFS 维护一个全局流表,flow (src_ip, dst_ip, src_port, dst_port) → 目标 CPU。在DPDK / AF_XDP 等 RSS 绑定核心的场景下没用,一般用在应用不绑核或者频繁迁移的时候。容器环境,容器IP变化频繁,RSS静态哈希可能不均衡,RFS 动态修正。

    3. XPS

    Transmit Packet Steering,解决的是发出去的包应该在哪个TX queue上。

    建立 CPU 到 TX queue 的映射,一个CPU 只用一个 TX queue发包

    • 不同的CPU用不同的 TX queue,无锁竞争
    • 每个TX queue 的 descriptor ring 是 per-CPU独占的,发包全程在 local cache 上完成
    # TX queue 0 → CPU 0
    echo 1 > /sys/class/net/eth0/queues/tx-0/xps_cpus

  • Kernel bypass #3 ef_vi

    ef_vi(Ethernet Fabric Virtual Interface) 是 Solarflare / Xilinx / AMD 网卡的最低级用户态 API,也是 Onload 协议栈的底层引擎,它把网卡的收发包环(rings)直接暴露给用户进程,实现完全内核旁路。

    1. Virtual Interface(VI)

    VI 是核心抽象,代表网卡为应用分配的一个独立的收发对象,每个VI有自己的 RX queue 和 TX queue。

    VI = 1 个 EVQ + 1 个 RX ring + 1 个 TX ring

    特征:

    • VI 之间硬件隔离,互不干扰
    • 每个VI 可以绑定到独立的 CPU core
    • 支持VI spreading,硬件将不同流的包散列到不同的 VI

    2. Event Queue(EVQ)

    EVQ是 ef_vi 的事件通知机制,也是一个ring buffer。

    主要事件类型:

    • RX完成事件:包已写入RX ring
    • TX完成事件:包已从TX ring 发到线缆上
    • 管理事件:link up/down,MAC 地址变更等

    3. RX ring

    硬件写,软件读,每个slot包含tag,checksum,length,RSS hash,包数据等,软件处理完后重新 refill RX buffer,并通知硬件。

    4. TX ring

    三种发送模式

    1. 普通发送:应用填写buffer,硬件读取发送,完成后产生TX event
    2. DMA 发送:应用先DMA 拷贝数据到 TX ring 附近的内存,再推送给硬件
    3. CTPIO(Cut-Through PIO):CPU 通过 PIO 直接将数据写入网卡发送管线,网卡可以边接收边发送

    CTPIO为什么快

    DMA 路径:

    1. CPU在主机内存里面构造好包
    2. CPU 写 desc 告诉 NIC 包位置
    3. CPU 写 Doorbell 寄存器(通知NIC desc 就绪)
    4. NIC DMA 引擎构造 Memory Read TLP
    5. PCIe 往返:NIC,CPU/Root complex,内存控制器,DRAM,读回数据
    6. NIC DMA 引擎把数据搬进内部TX FIFO
    7. NIC MAC 引擎从TX FIFO 取出,发到网线

    PIO 路径:

    1. CPU在寄存器/缓存里构造包数据
    2. CPU执行 MOV 到 MMIO 地址(NIC BAR 映射的 TX FIFO)
    3. PCIe memory write TLP 把数据送到NIC
    4. NIC 直接把数据放进TX 管线(CTPIO 还是边写边发)
  • Kernel bypass #2 DPDK

    DPDK(Data Plane Development Kit) 是一套用户态高性能包处理库,能绕过 Linux 内核网络栈的数据面路径,直接从用户态程序操作NIC硬件收发数据包。

    内核只留一个极薄的 UIO/VFIO 驱动做硬件访问授权,数据完全走用户态。

    1. PMD(Poll Mode Driver)

    传统的内核路径是中断驱动,DPDK 采用轮询驱动,让用户态线程持续轮询网卡 RX/TX descriptor ring,检查描述符状态并批量收发包。

    2. HugePage

    DPDK 强依赖 Hugepage,在 rte_eal_init() 里面 mmap /dev/hugepages/rtemap_*。Hugepage 有以下好处

    1. TLB 命中率:更少的TLB entry,更容易命中TLB
    2. DMA 需要连续内存:连续的2M内存
    3. 锁定物理内存:Hugepage不会被swap

    3. Mempool

    DPDK的内存池,在HugePage上的一大块内存,每个buffer 固定大小,内部使用无锁 Ring 来维护 buffer 的空闲状态。以免触发 malloc。

    4. mbuf

    mbuf 是包在 DPDK 里面的 “sk buffer”

    mbuf 结构体:

    1. 数据指针(指向 data 的起始位置)
    2. 数据长度(pkt_len, data_len)
    3. 入端口(port)
    4. 接收队列(queue)
    5. RSS hash 值
    6. VLAN / timestamp / …
    7. next 指针(mbuf chain)
    8. headroom
    9. data(DMA 直接写入的位置)
    10. tailroom

    多包串联:如果一个包的payload 很大,一个mbuf 放不下,就会用next指针将多个mbuf 串成链。

    5. Ring

    rte_ring,DPDK 自带无锁队列

    • 支持SPSC / MPMC
    • 批量操作:一次入队32个指针,分摊 CAS 开销
    • Ring 里面存的是 mbuf 指针

    Refs

    一些文档:https://github.com/0voice/dpdk_engineer_manual

    官方库:https://github.com/DPDK/dpdk

  • Kernel bypass #1 内核路径

    内核路径

    1. 光纤
    2. PHY(物理层):SerDes 转换(Serializer/Deserializer)
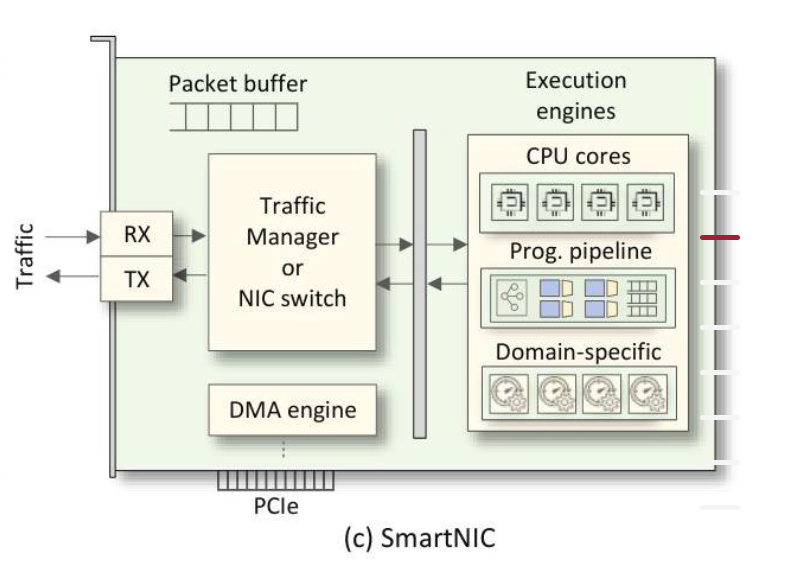
    3. MAC:负责以太网成帧/解帧,FCS校验,MAC地址过滤(网卡内部的MAC芯片负责)
    4. NIC网卡:网卡内部有SRAM做数据缓冲
    5. RSS分流:对五元组算(src_ip, dst_ip, src_port, dst_port, protocol)分流到不同的RX queue
    6. DMA:一种机制,网卡根据 RX descripor 中的 DMA 地址,将收到的包直接写入主机 DRAM 中的 DMA buffer(无须CPU搬运数据)
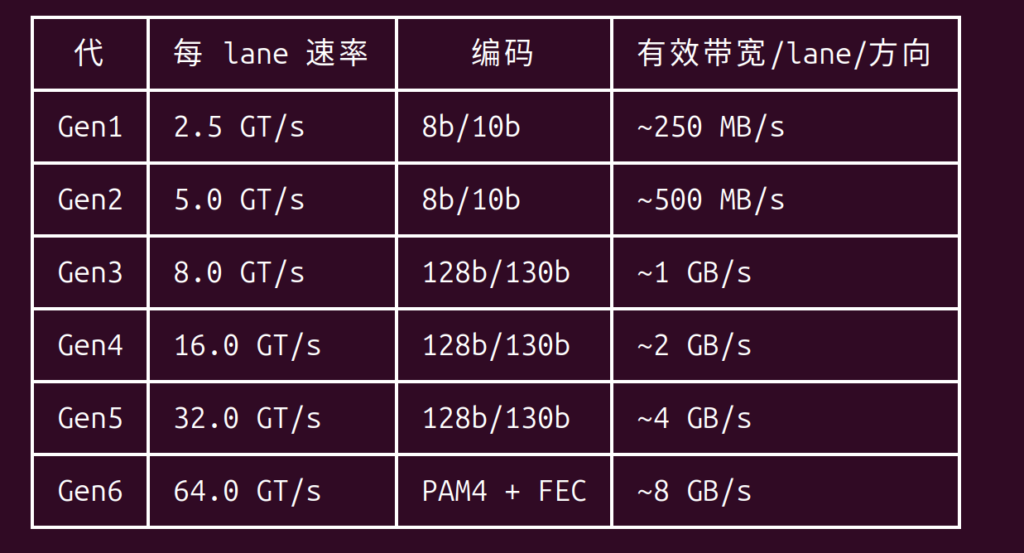
    7. PCIe总线:物理层(128b/130b),网卡和CPU的数据总线
    8. RX/TX descriptor ring:存在DRAM的描述符环,里面主要是 DMA buffer 地址,长度,状态等元数据,RSS 会把流量分到不同的 RX queue
    9. MSI/MSI-X中断:用PCIe message通知CPU有数据来了
    10. NAPI:中断+轮训,然后在softirq 的 poll 收包
    11. sk_buff:Linux 内核表示网络包的核心数据结构
    12. 协议栈(IP-TCP/UDP-socket):内核负责协议处理,并把数据放入 socket receive queue;当用户调用 read / recv 时,再从内核buffer 拷贝到用户 buffer
    13. read()/recv()/ syscall:用户读取数据

    名词学习

    1. PHY

    PHY 是物理层相关模块,负责链路层以下的信号处理,SerDes,时钟恢复,编码解码,链路训练等。PHY 负责将底层电信号处理成MAC可以理解的数据流。

    2. MAC

    MAC 负责以太网二层处理

    • 以太网帧的发送和接收
    • 源/目的 MAC 地址的处理
    • FCS 生成和校验
    • VLAN,checksum offload 等硬件卸载能力的配合

    3. DMA

    网卡把数据写入RX descriptor 指向的 DMA buffer 的机制,NIC 内部的DMA 引擎先构造 PCIe Memory Write TLP(Transaction Layer Packet)。然后经过 PCIe 链路发到 Root Complex(CPU/南桥内),通过 Root Complex 路由到内存控制器,然后写入 DRAM 中的 DMA buffer。

    4. RSS

    RSS 分流,网卡对于每个接受包提取五元组(src IP, dst IP, src port, dst port, protocol)做哈希,然后通过哈希选一个接受队列,保证同流保序,不同的队列绑定不同的CPU 核心,独立中断。这个是在 DMA 写入主机内存前决定的:RSS先选择RX queue,然后网卡使用该 queue 的 RX descriptor,把数据写入对应 DMA buffer。

    5. MSI / MSI-X

    Message Signaled Interrupt 和 MSI Extended 是 PCI/PCIe 设备的中断机制,用内存写事务替代物理中断引脚来通知CPU。

    • 传统 INTx:拉低物理IRQ 线,中断控制器,CPU
    • MSI/MSI-X:设备发PCIe memory write TLP 写入特定的 MSI/MSI-X 地址,平台中断控制器/APIC 机制再把中断投递到目标CPU

    LAPIC(Local Advanced Programmable Interrupt Controller,本地高级可编程中断控制器) 是 x86
    CPU 每个核心内部集成的一个硬件模块,负责管理该核心的中断

    为什么RSS通常搭配MSI-X:RSS 每个接收队列需要绑定独立中断和CPU,MSI-X给每个队列分配一个独立的中断向量,不同的向量路由到不同的CPU核的 LAPIC。如果没有MSI-X,所有队列共用一个中断,RSS的多队列分流就白做,中断还是会打断同一个CPU。

    6. Interrupt coalescence

    中断聚合,网卡攒够一批包发一次中断的技术,高吞吐场景下,每秒都有几十万到上百万的包,如果每个包都触发中断,CPU会无法正常工作。

    与内核 NAPI 结合

    linux NAPI 的 poll 模式天然配合中断聚合,一次中断后内核用 poll() 在 budget 限制内尽量处理队列里的包,然后在重新 arm 中断。

    7. PCIe

    分层

    1. 事务层:TLP 的组装 / 解析
    2. 数据链路层:序列号 + CRC
    3. 物理层:8b/10b 编码,128b/130b 编码,Ordered Sets,加扰

    Lane 与带宽

    PCIe Gen5 x16 全双工总带宽 = 32 GT/s * 128/130 * 16 / 8 * 2 = 126.03 GB/s

    8. Descriptor Ring

    描述符环是驱动和网卡之间共享的一块内存,用于协调包的收发,是DMA机制的核心数据结构。

    RX工作流程:

    1. 网卡通过DMA将包数据写到 desc 指向的 skb 缓冲区
    2. 网卡回填 desc 里面的元数据,翻转 OWN 位 “驱动”
    3. 网卡发 MSI-X 中断通知CPU
    4. 驱动 NAPI poll – 轮询 desc ring
      • 检查 desc[head].OWN == “驱动”
        • 取走 skb,递交协议栈
        • 分配新skb挂到 desc[head]
        • 设 OWN == “网卡”
        • head = (head + 1)% N
      • 否:没包了,结束poll

    TX工作流程:

    1. 驱动从协议栈里面拿到skb
    2. 找到空闲的 TX desc(OWN == 驱动)
    3. 把 skb 数据区的 DMA 地址填入 desc
    4. 设置 OWN == “网卡拥有”
    5. 写网卡tail 寄存器,通知网卡有新包要发送
    6. 网卡 DMA 从 skb 缓存区读取数据,打包发送
    7. 网卡回写 desc,OWN = “驱动”

    9. sk_buff

    Linux 内核网络栈中表示一个网络数据包的核心数据结构,从网卡驱动到 TCP/IP 协议,再到socket层,

    内部结构

    1. Headroom
    2. 链路层头(MAC)
    3. 网络层头(IP)
    4. 传输层头(TCP/UDP)
    5. payload(用户数据)
    6. Tailroom

    驱动通常提前准备好带有 headroom/tailroom 的skb 或 page buffer,网卡DMA写入后,驱动在 poll 中设置 skb 的长度,协议头指针,checksum 状态等元数据。

    10. copy_to_user

    #include <linux/uaccess.h>
    
    unsigned long copy_to_user(void __user *to, const void *from, unsigned long n);

    Linux 内核函数,将数据从内核空间拷贝到用户空间,内核与用户态之间安全传输数据的唯一

    内核访问用户态内存时应使用 uaccess 系列 API,例如 copy_to_user()、copy_from_user(),不能直接随意解引用用户态指针

    参考:

    https://www.alphaxiv.org/zh/overview/2405.09499v1

  • bpftrace

    用途

    bpftrace 是基于BFP(Bekeley Packet Filter)技术的 linux 上的动态追踪工具,可以让用户用简洁脚本探查内核和用户态运行时行为。

    常见的用途有:

    1. 定位性能瓶颈:定位某个函数平均执行时间,被调用次数
    2. 排查偶发故障:进程偶尔崩溃,需要追踪崩溃前的函数调用栈
    3. 理解未知代码行为:不知道为什么运行到某个地方,直接看清调用栈
    4. 线上排查:bpftrace 只读工具,不会修改内核/进程状态
    5. 统计聚合:按照进程/PID聚合时延分布

    原理

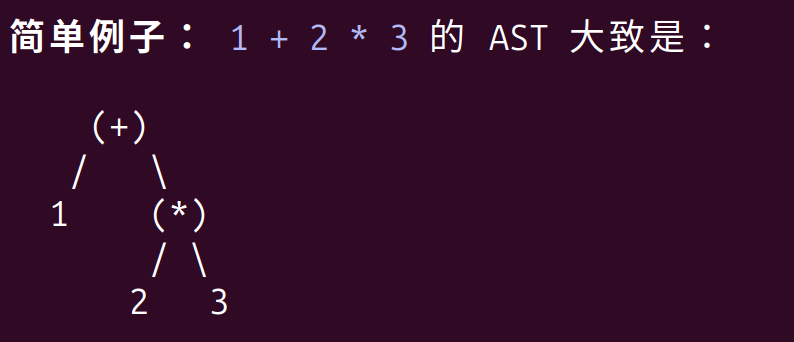
    1. 解析脚本:用 flex + bison 把脚本解析为 AST
    2. 语义分析:根据 probe 名确定 probe type,解析内建变量对应的 eBPF helper 或 内核字段,验证类型一致性
    3. 代码生成:把AST翻译为 eBPF 指令序列
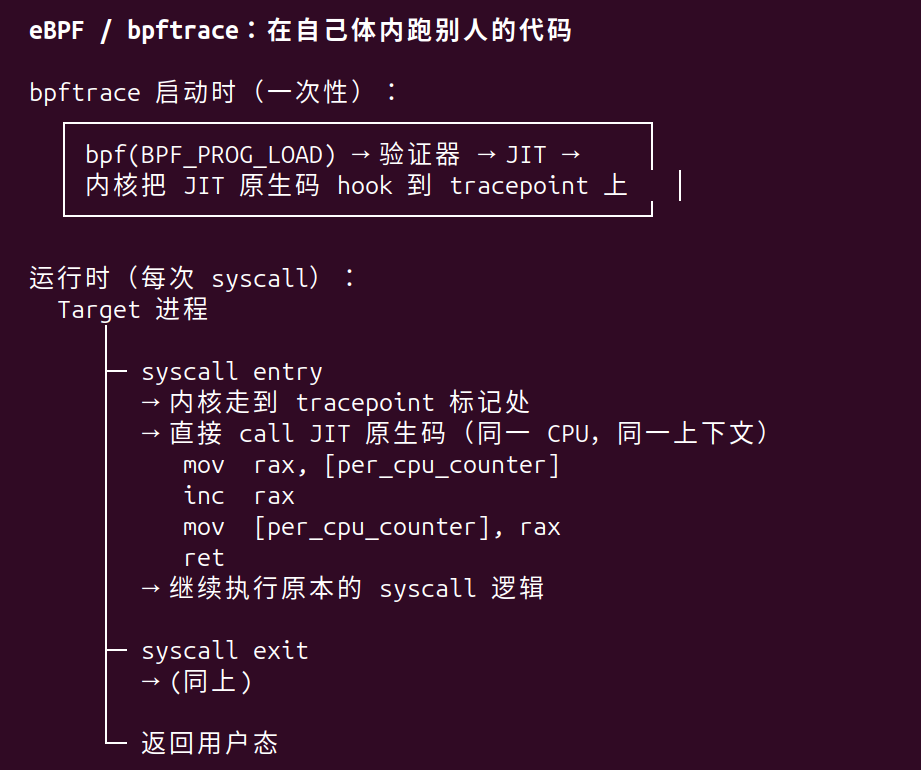
    4. 内核加载:BPF程序( 字节码)->bpf()系统调用加载 -> verifier 验证 -> JIT 编译 -> attach 到内核事件源

    probe 触发时,eBPF 程序在内核中执行,数据通过BPF maps异步推动到用户态,bpftrace 格式化输出。

    对比其他工具

    strace

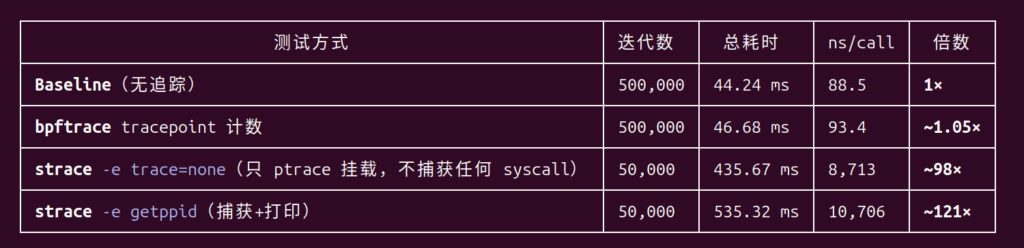
    strace 依赖 ptrace 模型,基于系统调用,每次系统调用都有非常大的开销,不适合生产环境。

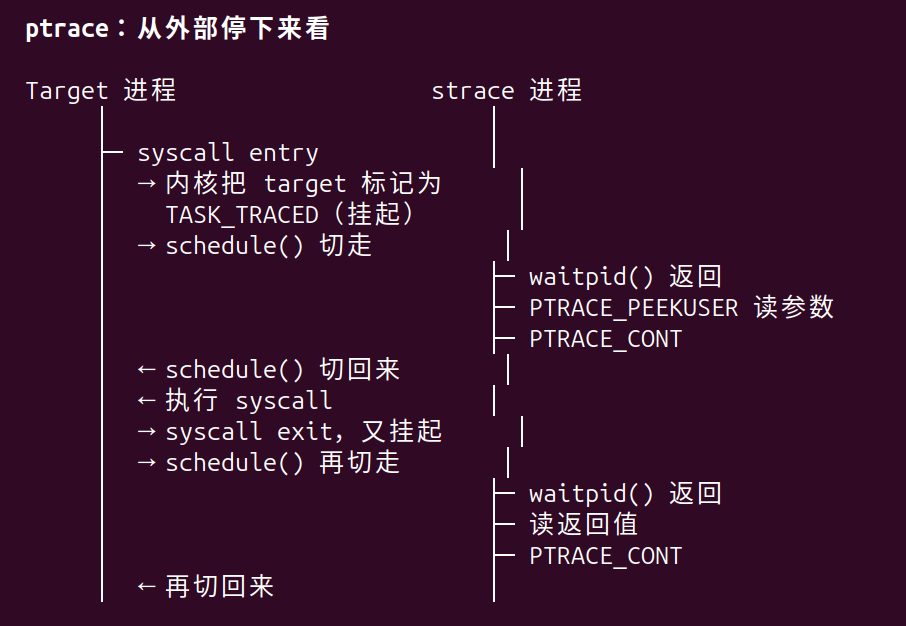
    1. 为什么strace 开销这么高:-e trace=none 不打印任何东西,但是每次syscall 还是要走 ptrace stop,通知strace,resume 的完整流程。
    2. bpftrace 5% 开销在哪:每次sys_enter_getppid tracepoint触发,跑一段JIT 原生码(读CPU id,取 map 指针,原子递增,perf_event_output 写 ring buffer)全程没有 context switch,在一个cpu上原地执行。

    perf

    相比与 perf,bpftrace的优点是更加灵活,可以自定义聚合逻辑。

    前置知识

    AST

    AST(Abstract Syntax Tree) 抽象语法树,是源代码的树状抽象表示,以属性结构描述代码的结构。

    JIT

    Just-In-Time,即时编译,是一种程序在运行时将代码编译为机器码的技术。介于纯解执行和提前编译(AOT)之间。

    eBPF 里面的 JIT 是将 eBPF 直接码加载到内核时编译成本地机器码的机制,让 eBPF 程序在呵呵中直接以原生速度执行,而不是被eBPF解释器逐条翻译。

    tracepoint

    tracepoint 是 Linux 内核中预埋的钩子点,类似于内核开发者在代码里面预埋的 printf 调试日志位置,默认关闭,0开销

    内核维护了一个tracepoint table, 每个tracepoint 有一个函数指针,默认情况下指向空操作,几乎0开销,分支预测器会直接跳过。当有bpftrace / perf / ftrace 附加的时候,指针会被替换为 回调 / BPF 程序地址。

  • GCC:__restrict__

    什么是__restrict__

      void add(float* a, float* b, float* c, int n) {
          for (int i = 0; i < n; ++i) {
              c[i] = a[i] + b[i];
          }
      }

    编译器优化内存访问的时候,最怕遇到的情况就是两个指针看起来不同,但是可能指向同样的地址,比如上面的代码,编译器需要考虑add(a, a, a, n) 这种情况。所以在做优化的时候会偏向于保守。

      void add(float* __restrict__ a,
               float* __restrict__ b,
               float* __restrict__ c,
               int n) {
          for (int i = 0; i < n; ++i) {
              c[i] = a[i] + b[i];
          }
      }

    __restrict__ 是向编译器保证,a,b,c三个指针访问的区域在函数执行的时候不会重合,以此来达到更好的优化目的。

    汇编分析

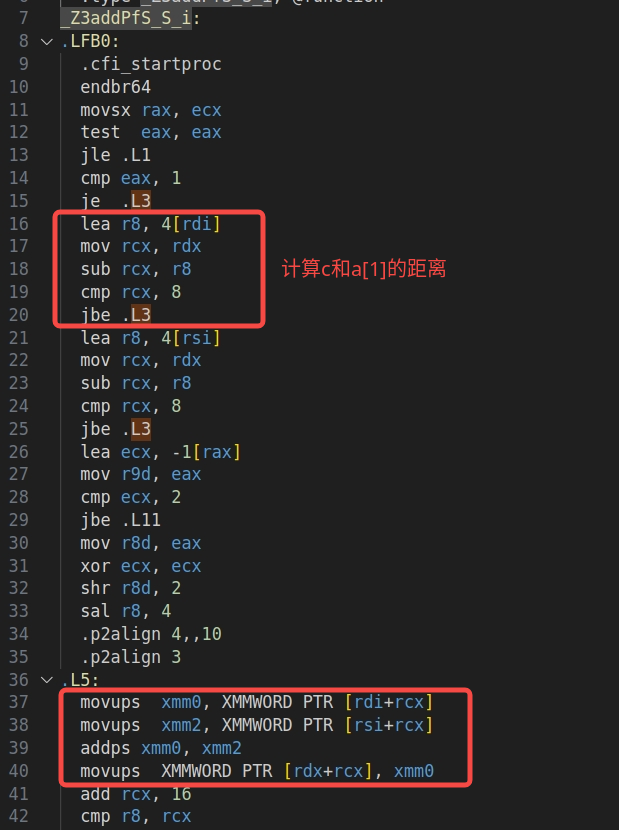
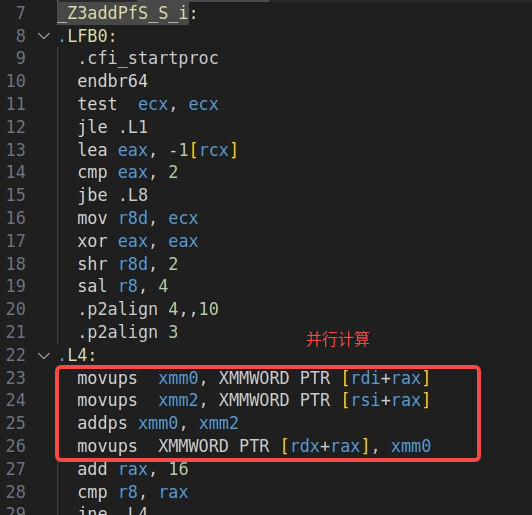
    左边是no restrict,右边是with restrict。

    • lea r8, 4[rdi]:rdi 是第一个参数将a + 4 赋值给r8 也就是 &a[1]
    • mov rcx, rdx:rdx是第三个参数,将c 赋值给rcx,也就是 &c[0]
    • sub rcx, r8:计算&c[0] – &a[1]的距离
    • cmp rcx, 8:距离 <= 8 ?
    • jbe .L3:距离太近就走标量保守方案

    同理rsi 是第二个参数b,也会做同样的判断,两者最后都会走到并行计算的代码,但是经过的路径是不一样的,如果没有restrict,代码会做一些判断,以及分析如果a 和 c相交还有b 和 c相交的情况的代码。

    并行计算代码(SIMD 向量化代码):

    • movups xmm0, XMMWORD PTR [rdi+rax] ; xmm0 = 从 a + offset 读取 4 个 float。
    • movups xmm2, XMMWORD PTR [rsi+rax] ; xmm2 = 从 b + offset 读取 4 个 float。
    • addps xmm0, xmm2 ; xmm0 = xmm0 + xmm2,4 个 float 并行相加。
    • movups XMMWORD PTR [rdx+rax], xmm0 ; 把 4 个结果写到 c + offset。
  • NMI

    什么是NMI

    Linux 里面经常谈到的 hardirq 和 softirq 是内核处理路径的分类。现在我们要讲的 maskable irq 和 non-maskable irq 是 CPU 硬件入口层的分类。普通的中断(maskable irq)会受到 IF 位的控制。当内核执行 cli 的时候,普通设备 irq, timer irq 这类可屏蔽中断不会被CPU接收,但是NMI / 异常 / SMI 依旧可以打断当前CPU。

    cli (clear interrupt flag), sti (set interrupt flag)是x86指令,用于清理/设置 RFLAGS.IF位,linux 内核会通过这些指令控制本CPU 是否接收普通外部可屏蔽中断。

    所以NMI 通常用到比较特殊的场景,类似于系统卡住,死锁,内核路径不可抢占等需要打断CPU做诊断或者处理事件的时候。

    什么情况下会有NMI

    1. watchdog:系统用来判断一个CPU是否卡死,配置在/proc/sys/kernel/watchdog_thresh,常见默认值10s。
    2. perf / PMU 采样:当使用perf record 命令的时候,PMU counter overflow 会产生PMI,然后PMI 通过触发 NMI delivery 进入内核,记录CPU当前 IP / call stack
    3. 调试/诊断机制:linux 有一些调试机制可以向CPU 发送 NMI,用于dump stack,诊断死锁,panic/kdump等。

    怎么看NMI 事件

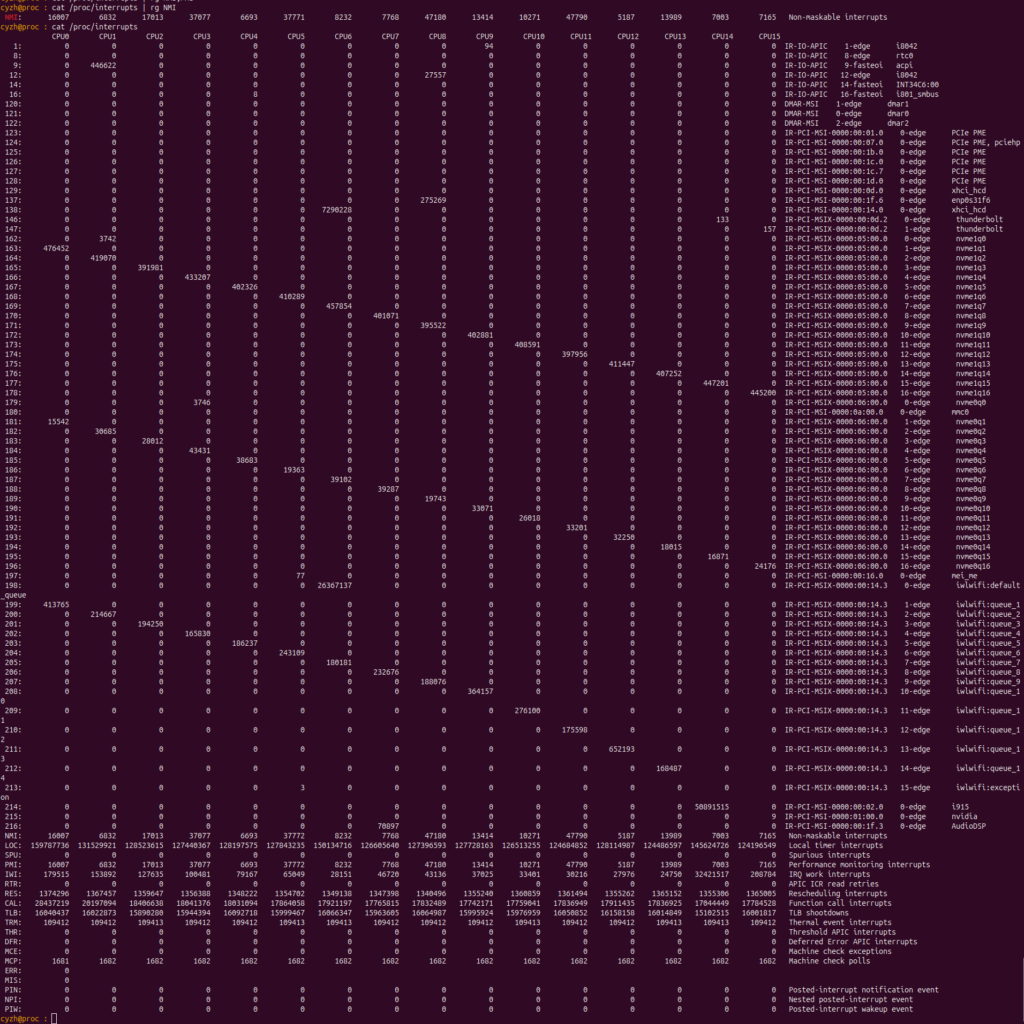
    cat /proc/interrupts
    cat /proc/interrupts | rg 'CPU|NMI|PMI'

    可以看到系统的每个CPU的所有中断的次数详情。

  • final 关键字

    final 关键字可以给编译器提供一个证明的功能,让编译器在优化虚函数的时候能够更加激进,从读虚指针然后跳转到虚函数。

    mov rax, [rdi]      // 读 vptr
    jmp [rax]           // 从 vtable slot 间接跳转

    优化到直接调用/内联具体函数

    int call_d(const D* p) {
        return p->f();
    }
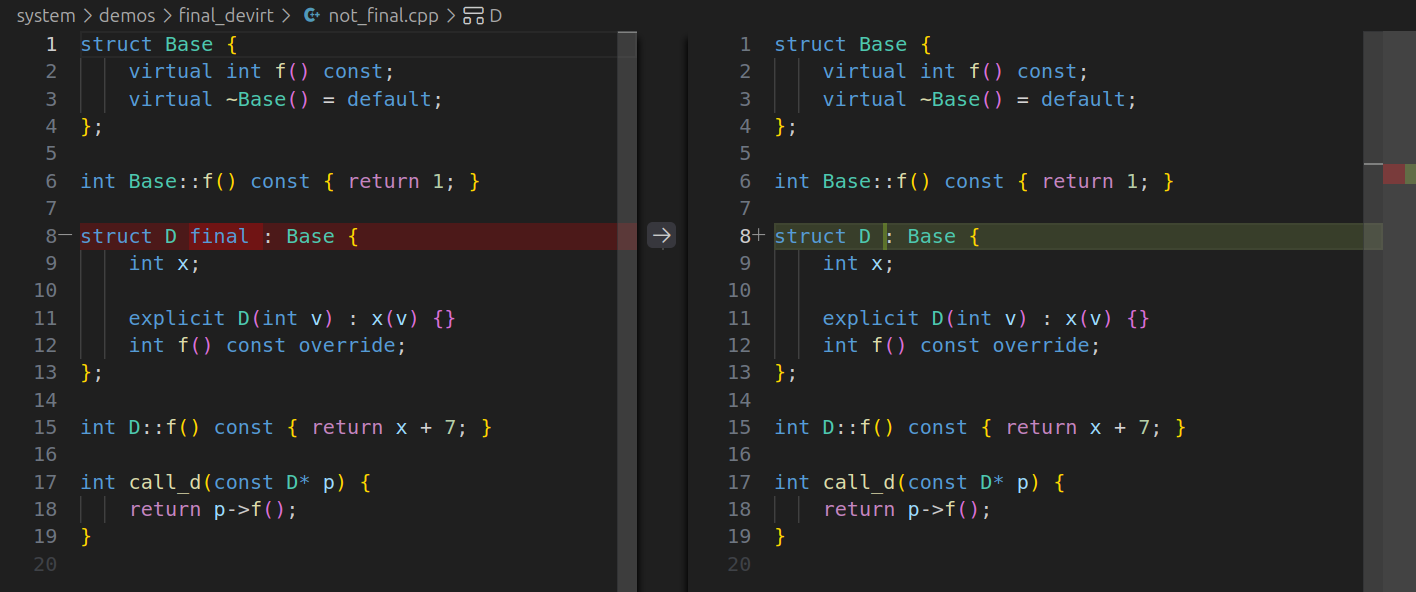
    • 如果 D 没有 final,在普通分离编译模型下,p 可能指向 D 的派生类对象,所以不能无条件去虚化
    • 如果 D final,编译器不需要看到全程序,也能证明 p->f() 只能调用 D::f()。

    样例

    首先来看一下.cpp实现,唯一区别是是否加 final

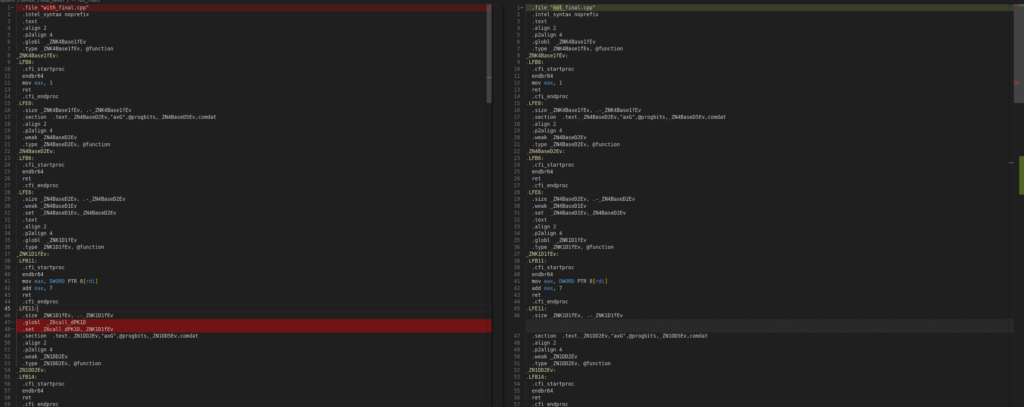
    然后编译得到汇编代码:

    g++ -O2 -std=c++20 -S -masm=intel with_final.cpp -o with_final.s
    g++ -O2 -std=c++20 -S -masm=intel not_final.cpp -o not_final.s

    从这个图不难看出,with_final 的版本

    • .set _Z6call_dPK1D,_ZNK1D1fEv:表示将call_d这个符号直接变成了D::f()的别名,调用call_d等价于调用D::f()

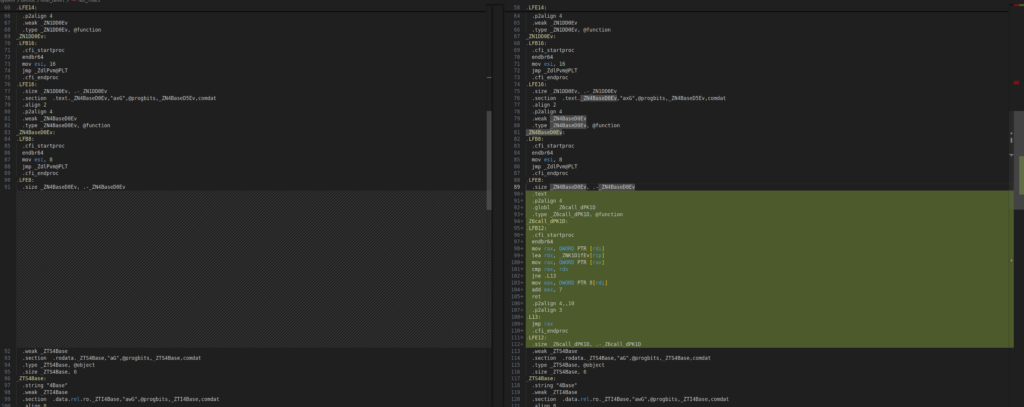
    然后not_final 的版本会多出一段汇编,具体内容就是

    • lea rdx, _ZNK1D1fEv[rip]: 将D::f() const 的函数地址放到 rdx
    • mov rax, QWORD PTR [rax]: 读取vtable[0]的实际地址,这里的[rax] 是从 vptr 指向的 vtable address point 开始取第一个虚函数的slot
    • cmp rax, rdx + jne .L13:如果vtable[0] != &D::f(),就跳转到.L13, 走保底的虚调用路径,如果相等,就走下面的已经inline的 D::f()快路径
    • 然后后面的部分是将D::f() inline进来的汇编。

    不难看出:

    • 加final 的时候:D不可能有派生类型,因此 const D* p 的动态类型只能是D,编译器不需要保留 guard 和 fallback 虚调用路径。会少走使用虚指针+虚函数表来查找函数地址的代码部分。
    • 不加final的时候:GCC做的是 guarded drvirtualization,先检查vtable slot 里面是否是 D::f(),如果是就直接走快路径,如果不是就跳到.L13 继续按照虚调用语义跳转到真实目标函数