什么是__restrict__
  void add(float* a, float* b, float* c, int n) {
      for (int i = 0; i < n; ++i) {
          c[i] = a[i] + b[i];
      }
  }
编译器优化内存访问的时候,最怕遇到的情况就是两个指针看起来不同,但是可能指向同样的地址,比如上面的代码,编译器需要考虑add(a, a, a, n) 这种情况。所以在做优化的时候会偏向于保守。
  void add(float* __restrict__ a,
           float* __restrict__ b,
           float* __restrict__ c,
           int n) {
      for (int i = 0; i < n; ++i) {
          c[i] = a[i] + b[i];
      }
  }
__restrict__ 是向编译器保证,a,b,c三个指针访问的区域在函数执行的时候不会重合,以此来达到更好的优化目的。
汇编分析
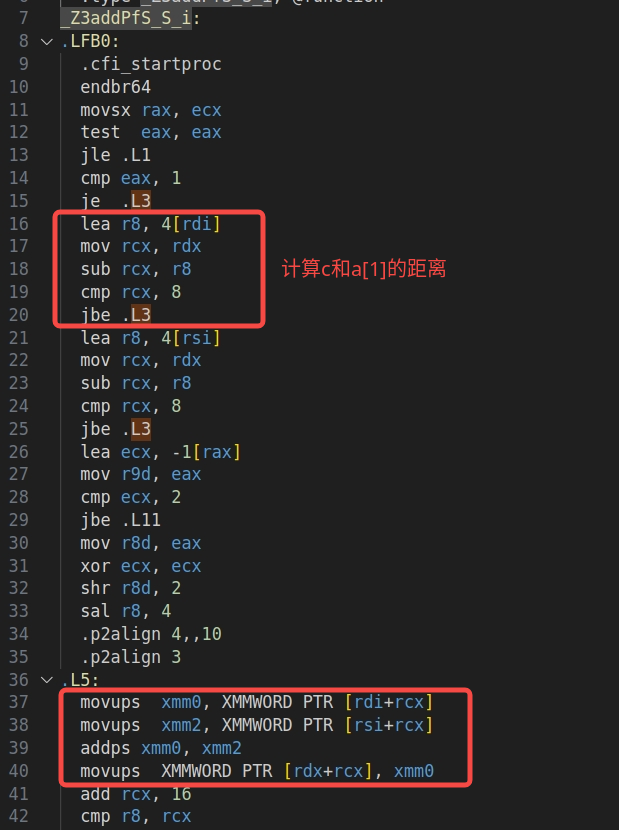
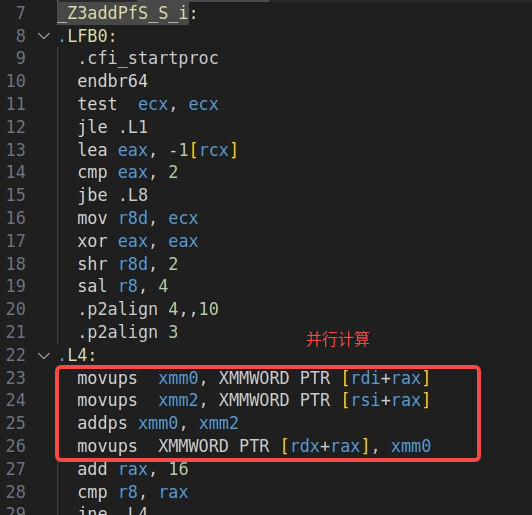
左边是no restrict,右边是with restrict。
- lea r8, 4[rdi]:rdi 是第一个参数将a + 4 赋值给r8 也就是 &a[1]
- mov rcx, rdx:rdx是第三个参数,将c 赋值给rcx,也就是 &c[0]
- sub rcx, r8:计算&c[0] – &a[1]的距离
- cmp rcx, 8:距离 <= 8 ?
- jbe .L3:距离太近就走标量保守方案
同理rsi 是第二个参数b,也会做同样的判断,两者最后都会走到并行计算的代码,但是经过的路径是不一样的,如果没有restrict,代码会做一些判断,以及分析如果a 和 c相交还有b 和 c相交的情况的代码。
并行计算代码(SIMD 向量化代码):
- movups xmm0, XMMWORD PTR [rdi+rax] ; xmm0 = 从 a + offset 读取 4 个 float。
- movups xmm2, XMMWORD PTR [rsi+rax] ; xmm2 = 从 b + offset 读取 4 个 float。
- addps xmm0, xmm2 ; xmm0 = xmm0 + xmm2,4 个 float 并行相加。
- movups XMMWORD PTR [rdx+rax], xmm0 ; 把 4 个结果写到 c + offset。
发表回复